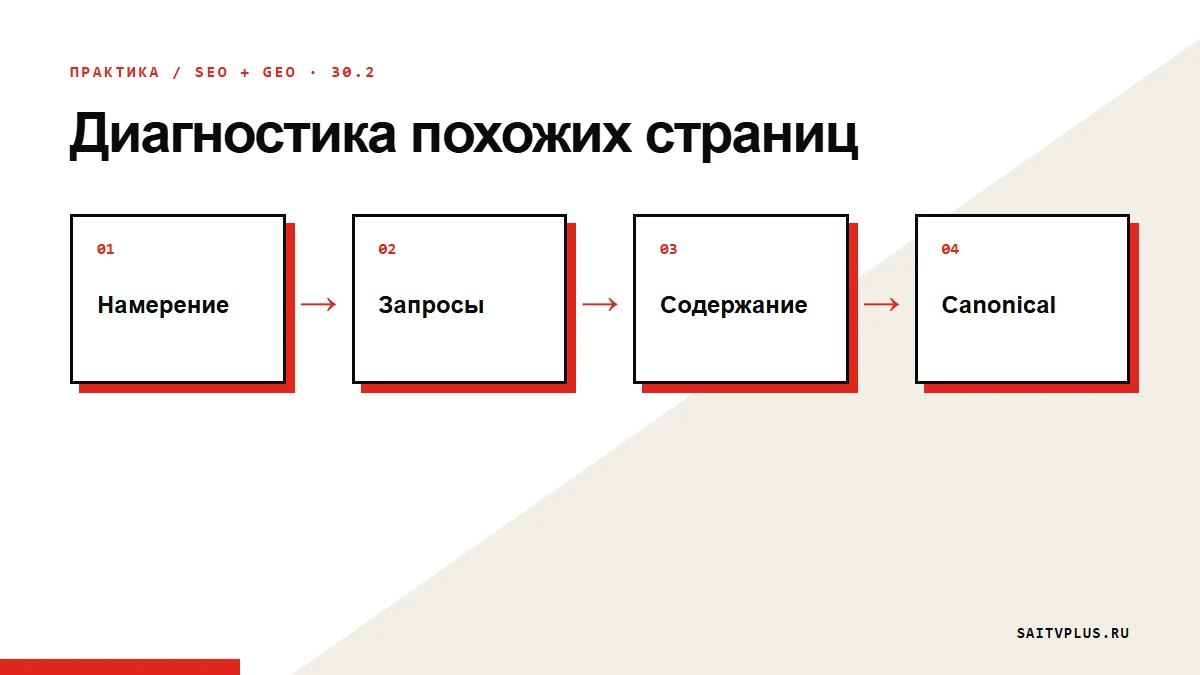
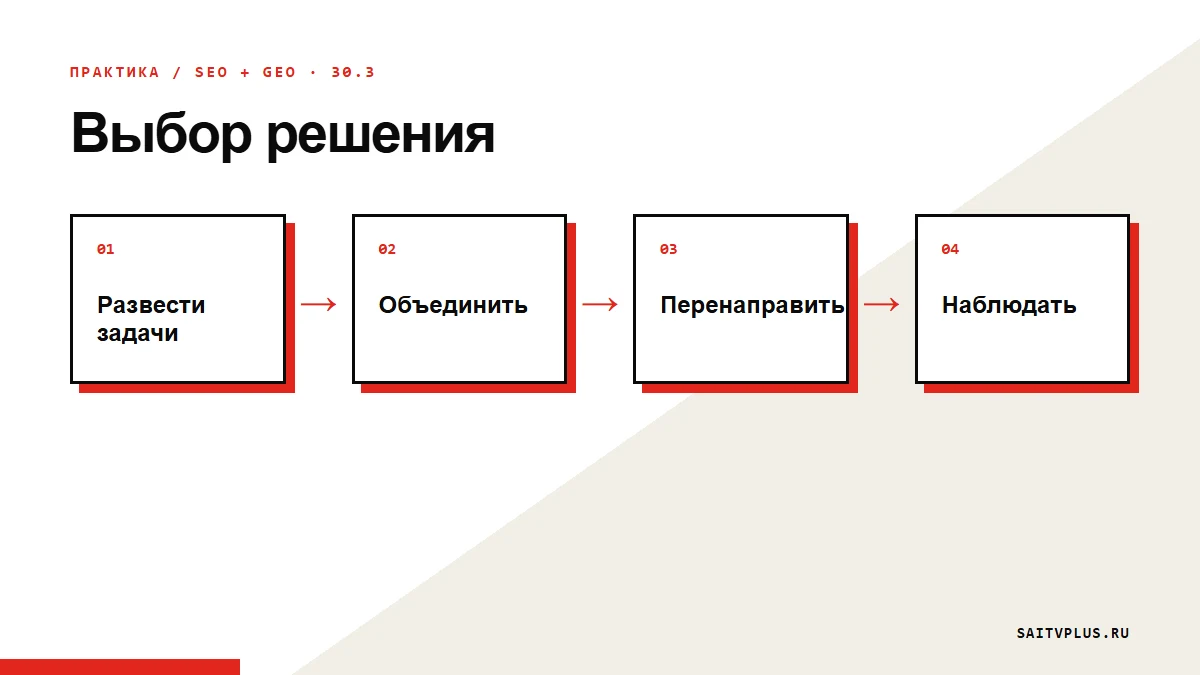
Каннибализация возникает не потому, что на сайте дважды встретилось одно слово. Проблема появляется, когда несколько URL претендуют на один и тот же ответ и владельцу сайта трудно объяснить, какую страницу показывать. Диагностика начинается с намерения и реальных данных, а заканчивается одним из четырёх решений: развести задачи, объединить содержание, перенаправить лишний URL или оставить страницы как есть.
Отличайте тематический кластер от конкуренции
Статьи одного кластера закономерно используют общую лексику. Материал «как выбрать тему» и инструкция «как составить контент-план» связаны, но дают разные результаты. Это не каннибализация, если заголовки, структура и полезное действие различаются.
Тревожный признак — две страницы с почти одинаковым H1, одинаковым намерением и повторяющимися разделами. Сегодня по запросу показывается одна, завтра другая; внешние и внутренние ссылки распределены случайно; ни один материал не даёт ясного полного ответа.
Не объявляйте проблемой сам факт, что несколько URL получают показы по одной фразе. Поисковая система может подбирать разные страницы под варианты контекста. Важно понять, есть ли у каждой собственная роль.
Соберите кандидатов из данных сайта
Начните с списка всех опубликованных URL, title, H1, главных запросов и заявленного намерения. Найдите близкие формулировки. Затем откройте Search Console и Яндекс Вебмастер: отфильтруйте важный запрос и посмотрите, какие страницы получали показы и клики.
Дополните данные поиском по сайту и внутренней таблицей контент-плана. Ручной оператор site: может подсказать кандидатов, но не заменяет кабинеты владельца и редакционную проверку.
Соберите пары или группы, а не пытайтесь сравнить весь блог одновременно. Для каждой группы запишите URL, запросы, намерение, возраст, показатели, входящие ссылки и текущий canonical.
Сравните намерение каждой страницы
Ответьте на четыре вопроса:
- Какую задачу человек решает этой страницей?
- Какой формат ответа он получает?
- Какой следующий шаг уместен после чтения?
- Чем материал отличается от соседнего URL в одном предложении?
Если четвёртый ответ сформулировать невозможно, страницы, вероятно, дублируют задачу. Если одна объясняет термин, а другая помогает выполнить процесс, различие можно усилить структурой и перелинковкой.
Сверьтесь с поисковым намерением, а не только со списком ключевых слов. Одинаковая фраза может появляться в разных материалах естественно.
Проверьте технические дубли URL
Иногда конкурируют не две статьи, а две версии одного документа: HTTP и HTTPS, со слешем и без, с параметрами, метками или печатным шаблоном. Это задача канонизации, а не переписывания текста.
Google рекомендует последовательно использовать редиректы, rel="canonical", Sitemap и внутренние ссылки на предпочтительный URL. В руководстве по canonical подчёркивается, что сигналы должны согласовываться и robots.txt не следует использовать как способ канонизации.
Яндекс также объединяет одинаковые или схожие страницы в группу дублей и выбирает каноническую. Его справка о каноническом адресе предупреждает, что указание является рекомендацией и может быть проигнорировано при противоречиях.
Не лечите редакционный дубль одним canonical
Canonical полезен для одинаковых или почти одинаковых версий URL. Он не решает вопрос, зачем на сайте существуют две самостоятельные статьи с одним намерением. Читатели всё равно будут попадать на обе по внутренним ссылкам, а редакция продолжит обновлять повторяющийся материал.
Если две статьи нужны, разведите их задачи. Перепишите вступление, H1, разделы и CTA так, чтобы каждая давала отдельный результат. Не ограничивайтесь заменой одного ключа синонимом.
Если одна страница больше не нужна, выберите основную, перенесите уникальную пользу и настройте постоянное перенаправление. Обновите ссылки и Sitemap. Не оставляйте удалённый URL отвечать 200 пустой заглушкой.
Выберите ведущую страницу по смыслу
Не всегда нужно сохранять URL с самой высокой текущей позицией. Смотрите на соответствие намерению, полноту ответа, качество ссылок, стабильность адреса и роль в структуре сайта. Более старый материал может быть слабее, но иметь полезные внешние ссылки; новый — точнее соответствовать услуге.
Выбор должен быть документирован. Запишите, почему один URL становится ведущим, какие части переносятся и что происходит с другим. Тогда через полгода редакция не создаст прежний дубль заново.
Не объединяйте материалы механически. Удалите повторы, соберите новую логичную структуру и проверьте факты. Сумма двух текстов часто хуже одного отредактированного ответа.
Разведите страницы с разными задачами
Когда обе страницы полезны, назначьте каждой отдельное намерение. Например, одна объясняет, что такое FAQ, вторая показывает, как собрать вопросы и разметить блок. Уточните H1, title, вводный ответ, примеры и внутренние анкоры.
Свяжите страницы контекстно: «если Вам нужен выбор вопросов — читайте…», «если нужна техническая разметка — переходите…». Ссылка должна объяснять различие, а не повторять один и тот же анкор.
Проверьте каталог и страницы услуг. Они должны вести на подходящий материал, а не случайно распределять сигналы между похожими URL.
Объединяйте и перенаправляйте аккуратно
Перед изменением сделайте резервную копию. Подготовьте обновлённую ведущую страницу локально. Перенесите только уникальные и актуальные фрагменты, исправьте метаданные, FAQ, изображения и даты.
После публикации настройте постоянный редирект со старого URL на наиболее близкий новый. Удалите старый URL из Sitemap и замените внутренние ссылки. Проверьте отсутствие цепочки редиректов.
Не направляйте все удалённые статьи на главную: пользователь ждёт близкий ответ. Если подходящей страницы нет и материал действительно удалён без замены, корректный 404 или 410 честнее нерелевантного перенаправления.
Не используйте noindex как универсальное решение
noindex исключает страницу из поиска, но не объясняет архитектуру и не объединяет полезные сигналы так, как корректное перенаправление или канонизация. Он уместен для служебных страниц, а не как быстрый пластырь для редакционных дублей.
Robots.txt также не предназначен для выбора canonical. Закрытый от обхода URL может остаться известным системе без возможности прочитать его директивы. Выбирайте инструмент по задаче.
Если сомневаетесь, сначала сохраните обе страницы и уточните намерения. Разрушительное объединение без данных сложнее отменить, чем редакционную правку.
Проверьте результат после изменений
После выпуска откройте обе версии URL. Ведущая страница должна отвечать 200, старый адрес — ожидаемым редиректом, если он настроен. Проверьте canonical, Sitemap, внутренние ссылки, изображения и Schema.org.
В кабинетах поисковых систем смотрите выбранный canonical и страницы в поиске. Google отмечает, что повторная оценка группы дублей может занять время, даже после исправления содержания. Не создавайте новые противоречивые сигналы ежедневными изменениями.
Сравнивайте запросы и страницы на одинаковом периоде. Цель — не обязательно мгновенный рост, а устойчивое соответствие: по каждому намерению есть понятный ведущий URL.
Предотвращайте проблему контент-планом
До написания новой статьи проверяйте опубликованные H1, slug, главное намерение и структуру. В очереди фиксируйте не только тему, но и практический результат читателя. Это помогает заметить дубль ещё до производства.
Стройте кластер как набор разных вопросов: понять, выбрать, сделать, проверить, исправить. Если тема звучит похоже, сформулируйте отличие одним предложением. Не получается — объедините идеи в один материал.
После публикации добавляйте URL и главный запрос в журнал. Так редактор видит границы существующего контента, а не полагается на память.
Частые вопросы
Любые две статьи с одинаковым ключом конкурируют?
Нет. Общая лексика нормальна для тематического кластера. Проблема возникает при совпадении основного намерения и ответа.
Как найти каннибализацию в Search Console?
Отфильтруйте данные по запросу и посмотрите вкладку страниц. Затем вручную сравните намерение и содержание найденных URL.
Всегда ли нужно объединять похожие статьи?
Нет. Если они решают разные задачи, усилите различие. Объединение нужно, когда самостоятельную роль каждой страницы объяснить нельзя.
Поможет ли rel="canonical"?
Он помогает выбрать предпочтительную версию дублей URL, но не заменяет редакционную работу с двумя самостоятельными статьями одного intent.
Что делать со старым URL после объединения?
Настройте постоянный редирект на ведущую релевантную страницу, обновите внутренние ссылки и Sitemap, затем проверьте цепочку.
Можно ли закрыть лишнюю статью в robots.txt?
Robots.txt не является инструментом канонизации. Используйте редирект, canonical или корректный статус удаления в зависимости от ситуации.
Когда оценивать результат исправления?
После повторного обхода и обновления данных в поисковых системах. Конкретный срок не гарантируется, поэтому фиксируйте фактические статусы.
Если Вам нужен аудит структуры блога и карта пересекающихся страниц, посмотрите услуги проекта «Сайт в плюс». Мы сначала разберём намерения и только затем предложим техническое действие.
Для подготовки черновика можно рассмотреть сервис «0 рублей».
Материал содержит партнёрскую ссылку. После регистрации по ней и оплаты любого тарифа сервис автоматически начисляет одну статью в подарок; проект может получить вознаграждение без доплаты с Вашей стороны. Перед публикацией проверьте, не повторяет ли новый текст существующую страницу.